MiMo-V2.6:扩展强化学习规模,迈向自我提升
今天,我们正式发布并开源 Xiaomi MiMo-V2.6 系列。这是我们探索 RSI(递归自我改进)路径的关键一步:以可验证的复杂任务为基础,规模化扩展强化学习(RL)算力,让模型在持续的探索与反馈中不断拓展智能边界。
夫夷以近,则游者众;险以远,则至者少。在一个智能容易被复制的时代,我们选择把算力投进真实环境,让模型在反馈中一次次试错、自己学会。这条路更慢,也更少被看见。MiMo-V2.6 这 6 天的 Live RL 训练,是我们在这条路上的一次公开跋涉;而这 6 天的背后,是长达半年的基础研究积累和工程试错。
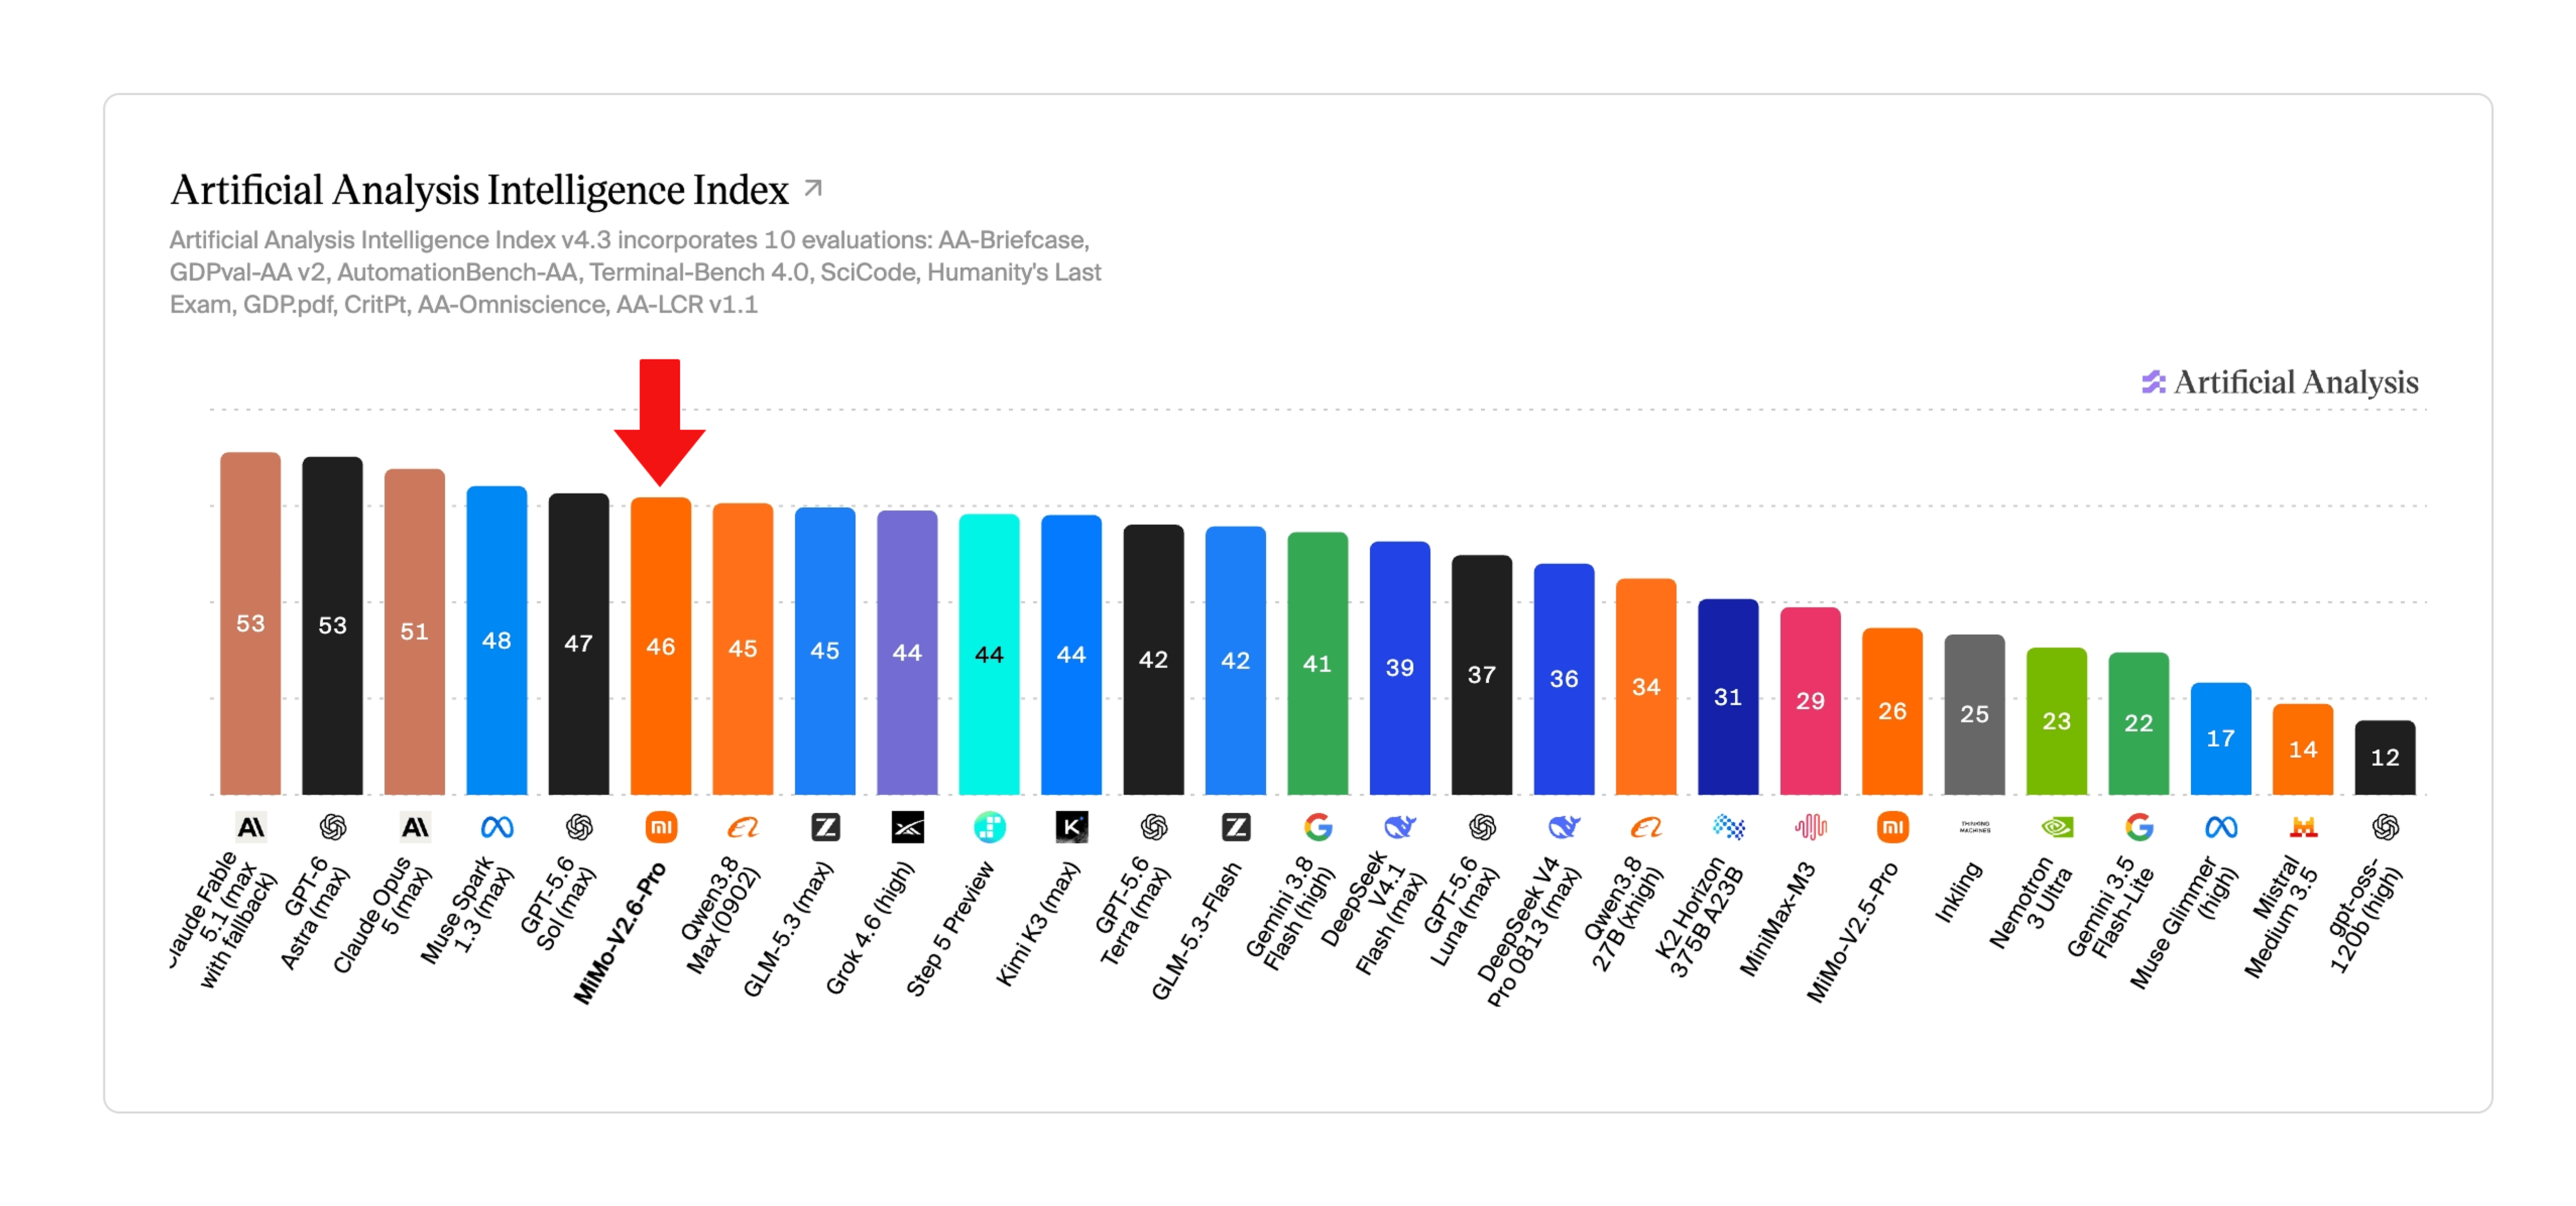
MiMo-V2.6 系列包含 Pro 和 Flash 两个原生全模态模型。得益于 RL 算力的扩展,MiMo-V2.6-Pro 在 Artificial Analysis Intelligence Index(AA 综合智能指数)中取得 46 分,超过 Kimi K3 和 Qwen3.8 Max,成为当前最强的开源模型;但与最强的闭源模型 Claude Fable 5.1 和 GPT-6 Astra 相比,仍有差距。
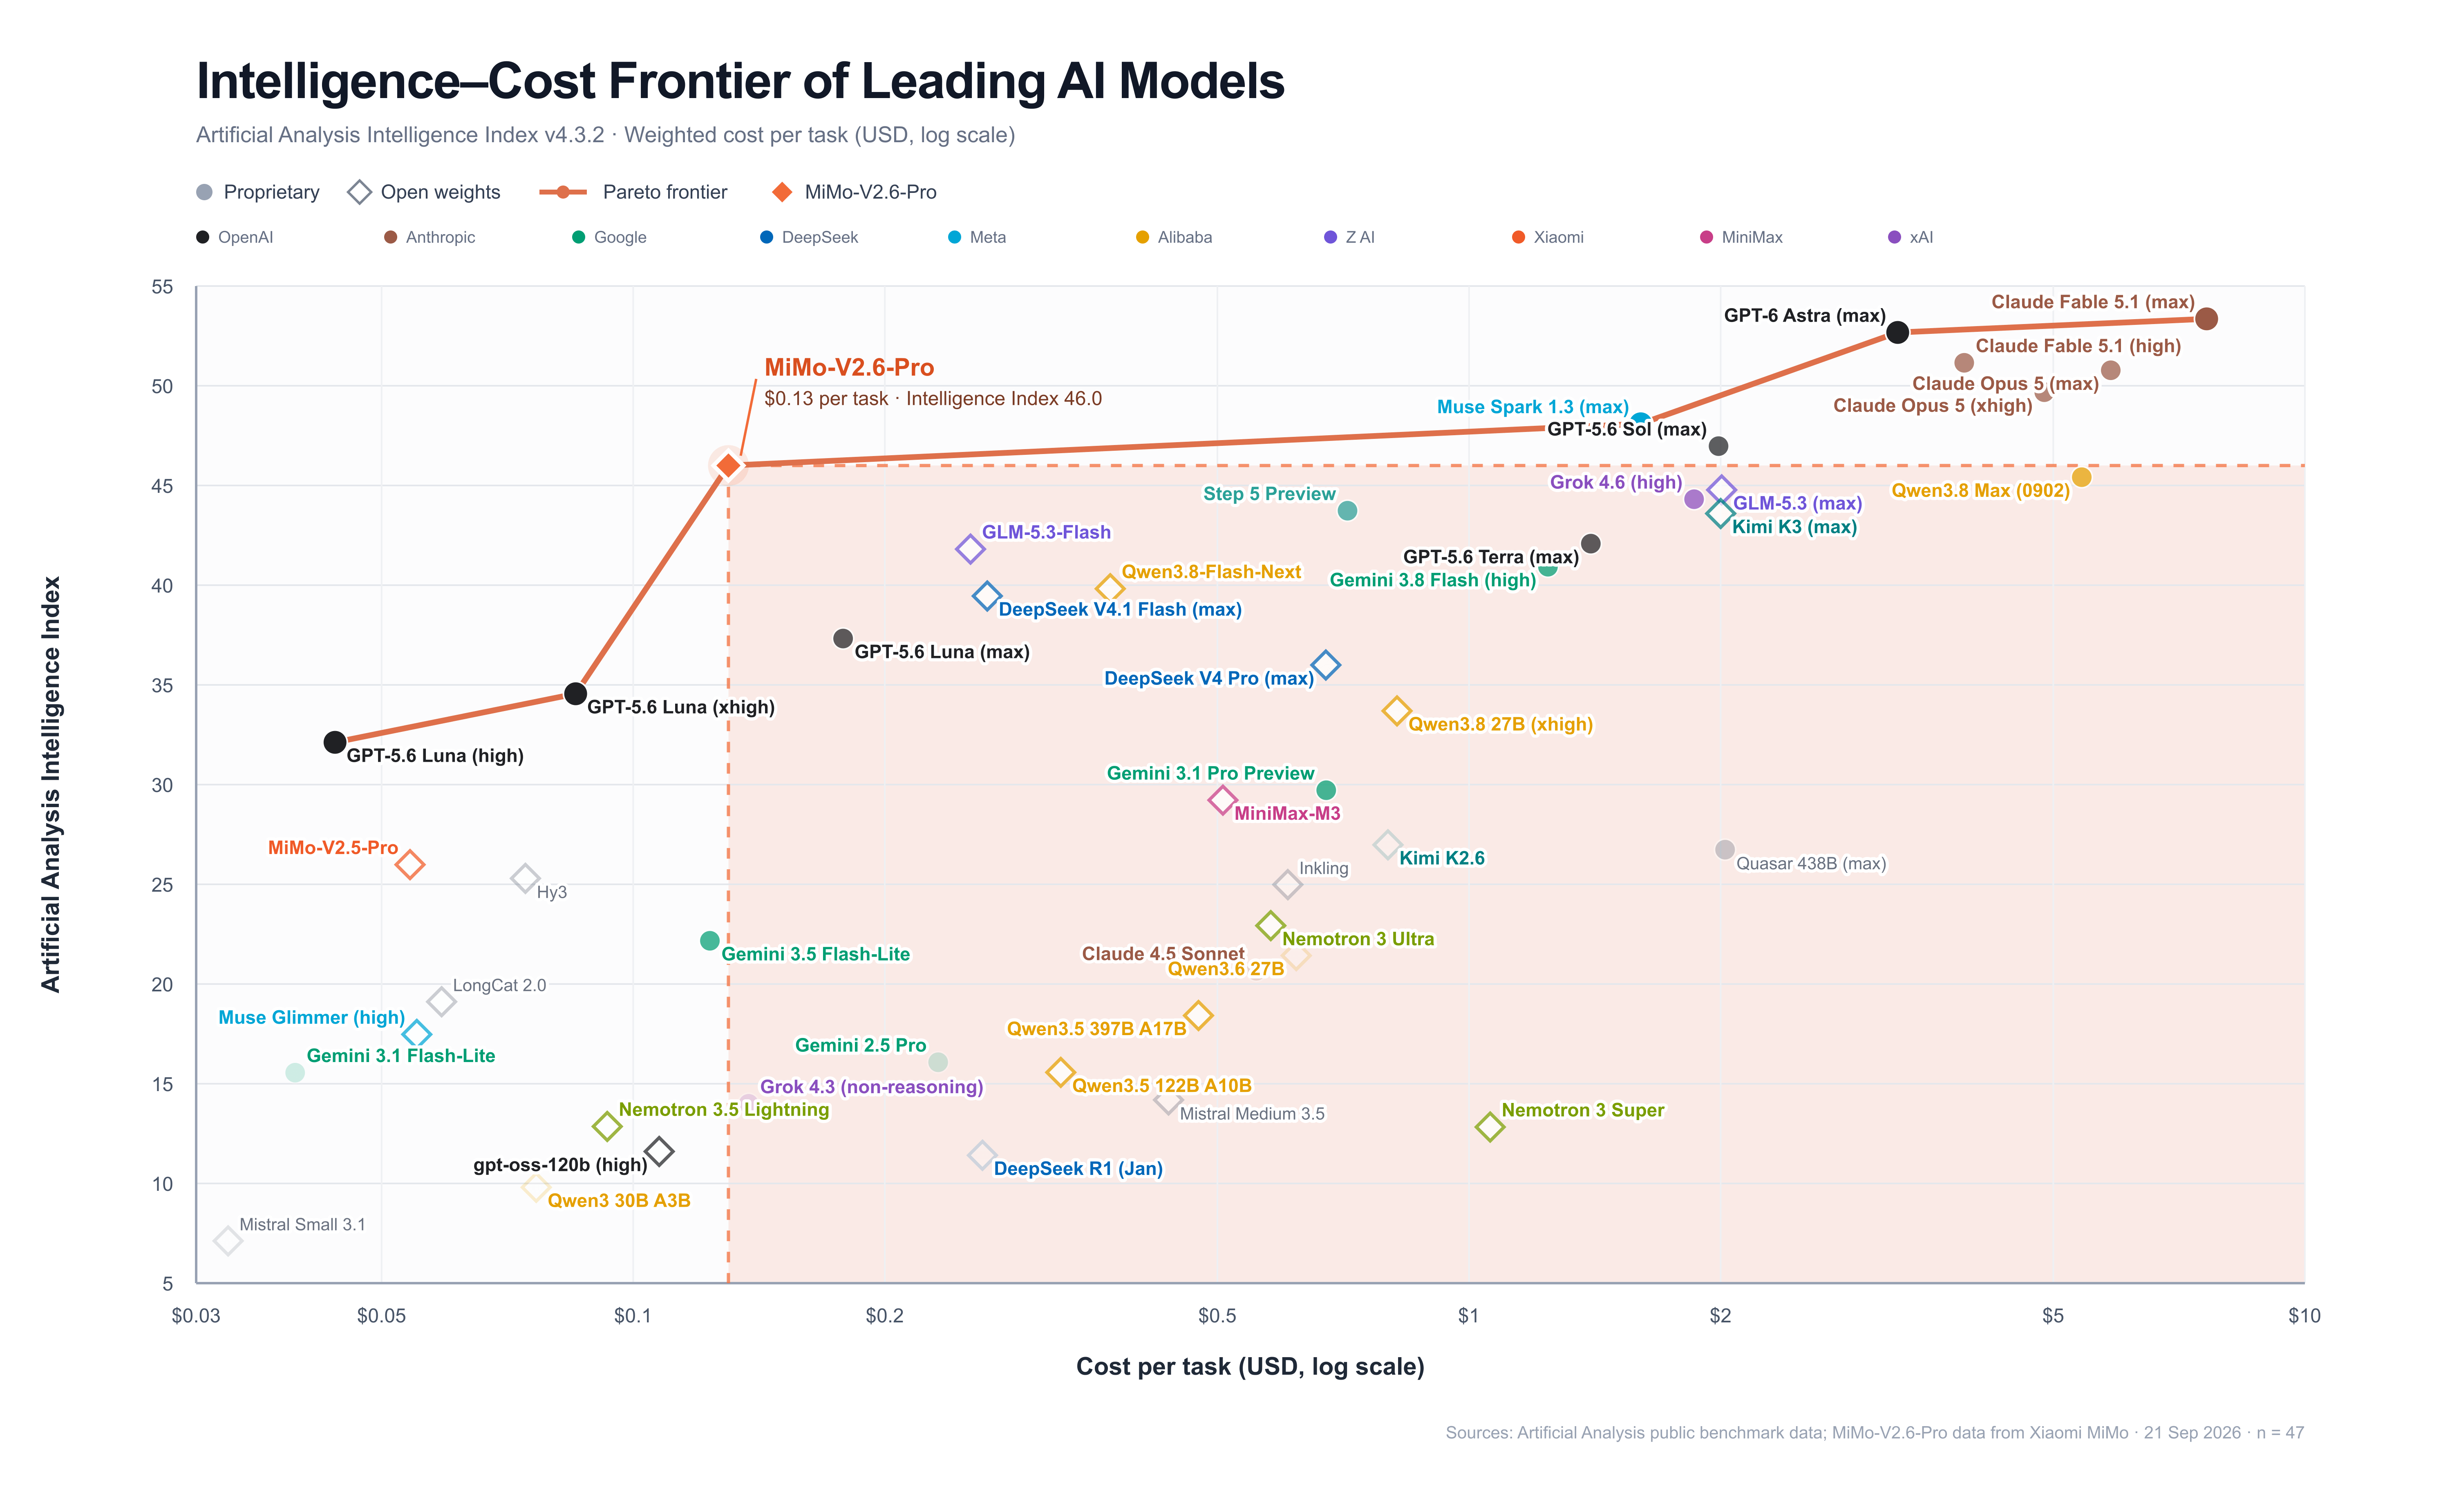
MiMo-V2.6 系列 沿用 V2.5 系列的 API 定价。智能提升,价格不变,“智能-成本”的帕累托前沿由此再度向外推进。MiMo-V2.6-Pro 刷新了国产模型的性价比纪录:在同等智能水平下,价格仅为海外模型的 1/20 至 1/60。
大规模扩展 RL 并全面开源
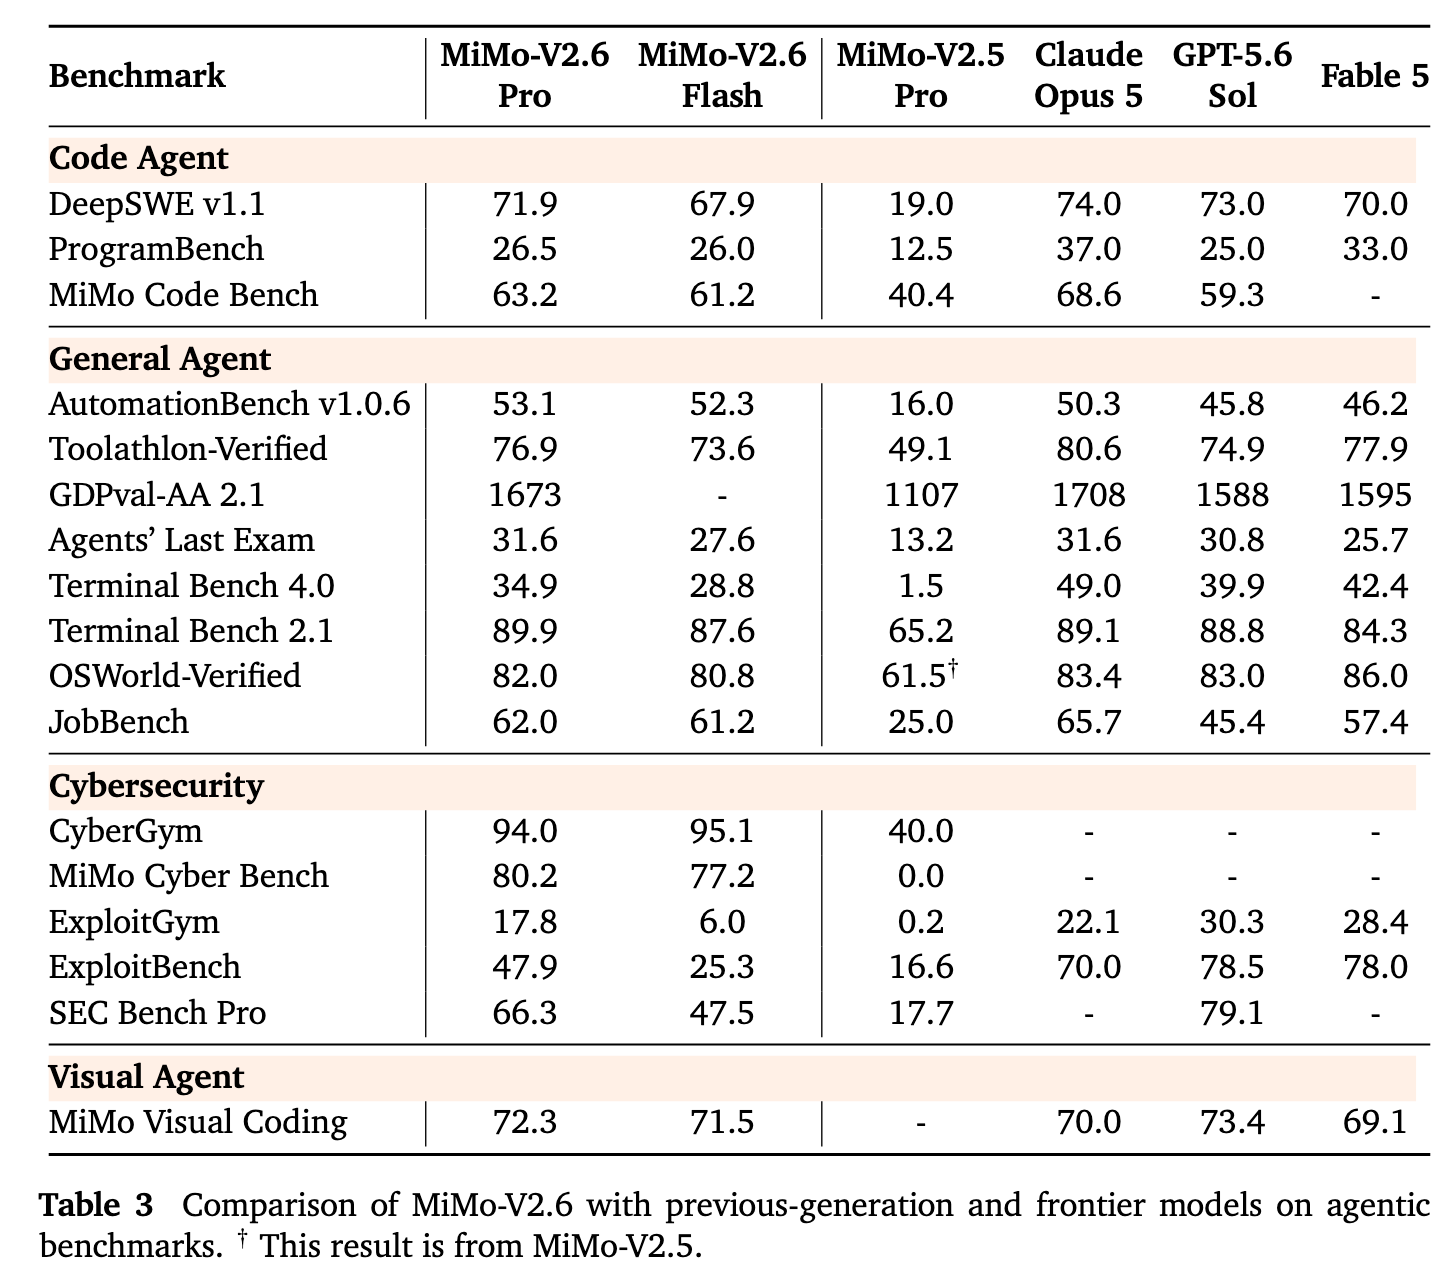
在 RL 训练阶段,MiMo-V2.6 可能是目前国产开源模型中投入算力最多的模型之一。经过大规模、多任务强化学习训练,MiMo-V2.6-Pro 在多数 Agent Benchmark 上取得了比肩 Claude Opus5 和 GPT-5.6 Sol 的效果,MiMo-V2.6-Flash 则全面超越 MiMo-V2.5-Pro**。**
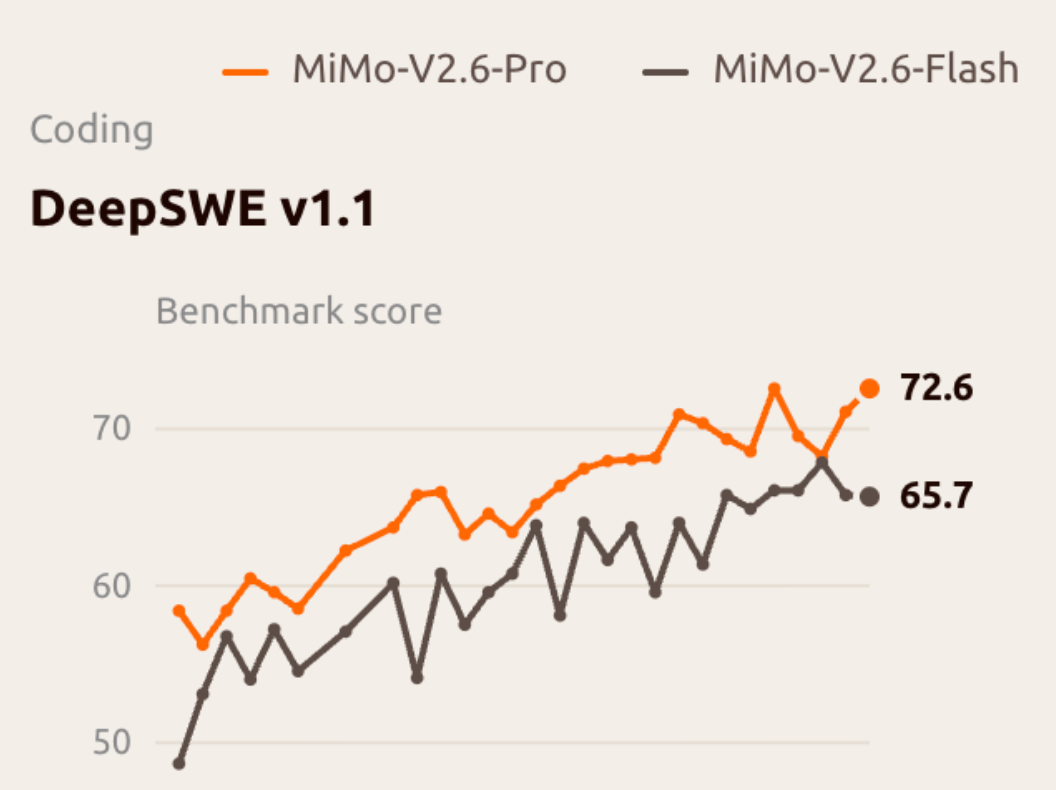
整个过程中,我们攻克了 RL 训练中的基础研究与工程挑战,并通过 Live 分享正式实验历程。历时不到 6 天,MiMo-V2.6-Flash 与 MiMo-V2.6-Pro 训练成本分别约 85 万与 262 万美元,各完成 30 步,累计约 75 万条轨迹;训练任务平均通过率分别相对提升 25% 和 12%,样本外的长程软件工程评测基准 DeepSWE v1.1 分别提升约 17 分(48.8 → 65.7)和约 14 分(58.4 → 72.6) ,体现出 RL 较高的样本效率、持续改进能力和样本外的泛化能力。
本次训练主要从三个维度扩展 RL 算力:
-
更大的 Batch 与更高吞吐:结合大 Batch 和全异步架构,单次更新使用 1,568 个样本,支持 1M 上下文长度训练,单步训练 Token 达 3.5~3.7B。
-
更多任务与复杂环境:构建覆盖 Code、General、Visual、Cyber 等方向的多任务训练体系,并混合多个 Harness,促进不同能力维度协同提升。
-
更大的 Grader 算力:通过 Group 内相对比较,为 Long-Horizon RL 任务提供更精准、多样的奖励信号,形成模型自我改进闭环,并引导模型以更短路径、更少 Token 完成任务。
随着训练规模扩大,我们冻结 MoE Router 以抑制专家负载漂移,并建立覆盖奖励设计、对抗性评测、异常检测和验证器交叉校验的 Reward Hacking 防线,提升训练稳定性与奖励可靠性。
为支撑大规模混合任务的智能体强化学习,我们设计统一的轨迹表示与惩罚机制来细化学习信号,支撑多种智能体框架的高并发交互,解耦控制面与数据面以支持海量轨迹的迁移,在混合批次中稳定各任务的样本配比,并优化训练与推理引擎的效率及它们的一致性。
我们已开源上述技术成果及配套资源,包括完整技术报告、训练环境与 RL代码,帮助更多研究者复现和验证相关结果,共同探索规模化 RL 与模型自我改进的更多可能。
从 Vibe Coding 到 Vibe World
MiMo-V2.6 融合了 3D 空间推理、多模态感知与计算机操作(CUA)能力, 进一步拓展了编程所能触及的边界,它可以将自然语言驱动的编程任务拓展为面向交互世界构建的“Vibe World”。
3D 开放世界游戏
在游戏开发中,用户输入图片、视频或文字后,MiMo-V2.6 会将需求拆解为多个任务,由多智能体协作完成游戏 3D 场景搭建、交互逻辑编写与视觉验证,并根据渲染结果不断修正,最终生成符合用户意图的可运行交互世界。
Blender 3D 建模
MiMo-V2.6 能够根据用户的文字描述或参考图片,在 Blender 中完成物体与场景的三维建模,生成可用于动画制作、3D 打印与游戏开发的 3D 资产。
具身智能
在具身仿真环境中,MiMo-V2.6 可以直接以多视角相机画面为输入,持续进行推理与决策,并通过视觉反馈闭环控制 Franka Panda 机械臂,完成物体抓取、颜色匹配与精准放置。
Computer Use Agent
MiMo-V2.6 进一步拓展了 Computer Use 能力,将多模态感知与原生训练的行动能力相结合。它可以理解复杂的图形界面,使用常见办公与生产力工具,完成信息检索、编辑和数据处理等任务,并根据视觉反馈检查结果、排查问题、调整后续行动。
推动前沿科学研究
未经针对科研任务的专项强化学习训练,MiMo-V2.6 已在多个研究领域展现出应用潜力。从材料设计到数学形式化,以下案例展示了模型如何将推理、编程与工具使用能力应用于具体科研任务。
材料科研的 Co-Scientist
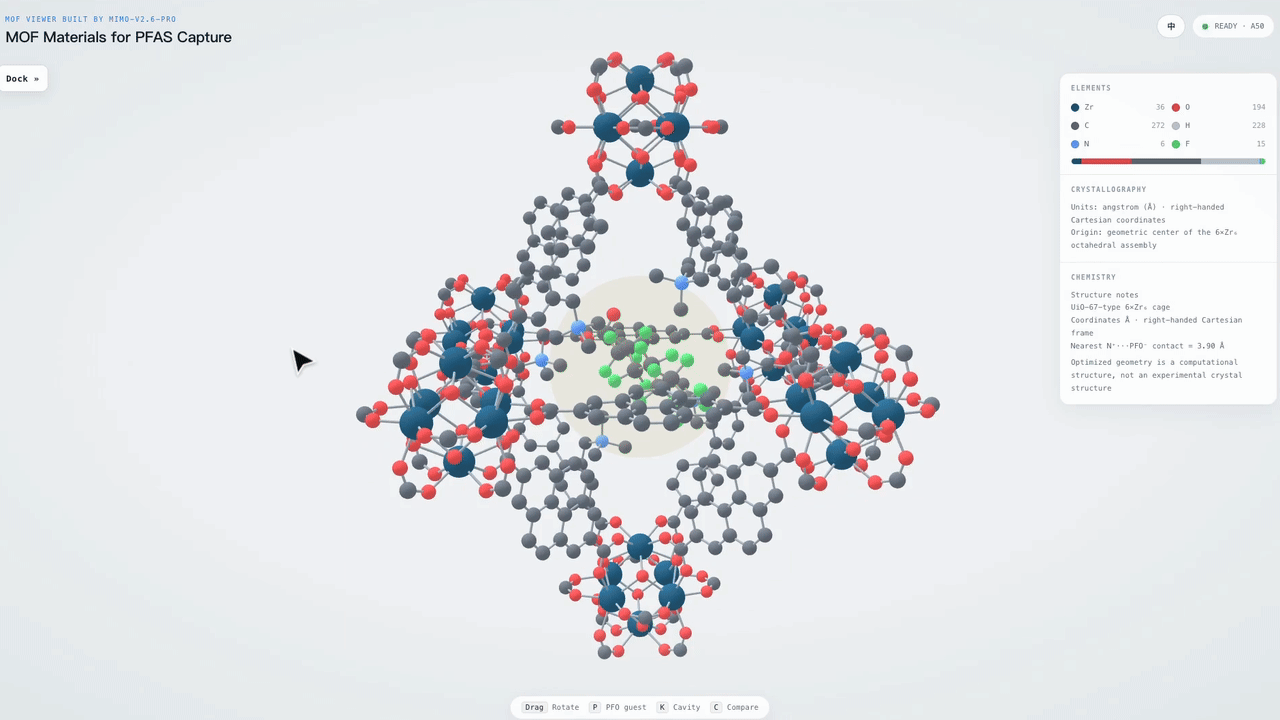
MiMo-V2.6-Pro 协助研究人员完成材料设计与计算筛选。在小米前沿材料研究团队的多轮提示与交互下,它提出了数种金属有机框架(MOF)材料的设计方案,目标是吸附被称为“永久性污染物”的全氟和多氟烷基物质(PFAS)。在这一过程中,模型检索并梳理相关文献与专利,提出研究假设,并评估设计方案的新颖性。
随后,它进一步开展了“干实验” :即调用开源计算工具,自动搭建模拟环境,计算设计出的 MOF 材料与 PFAS 之间的结合强度,从中筛选出最有潜力的候选材料,以供后续“湿实验”验证。
形式化数学证明
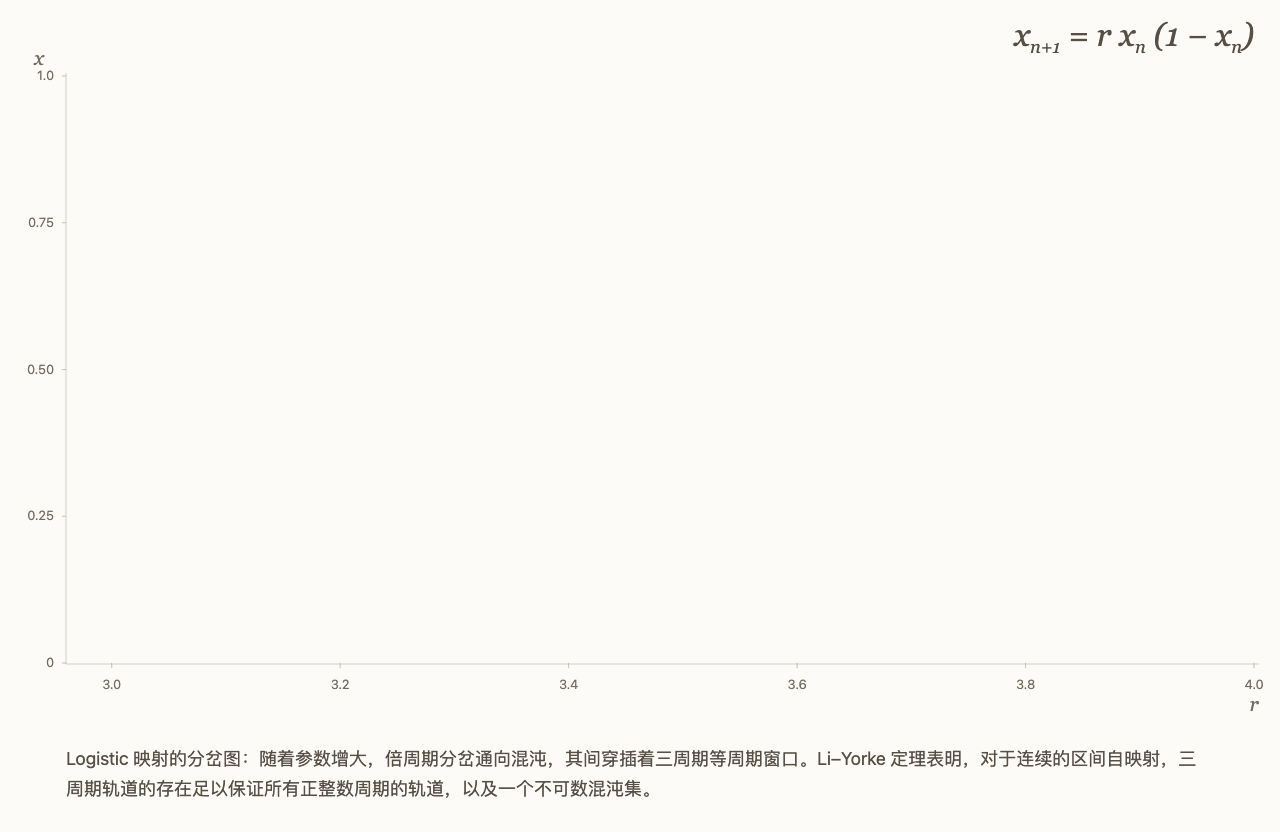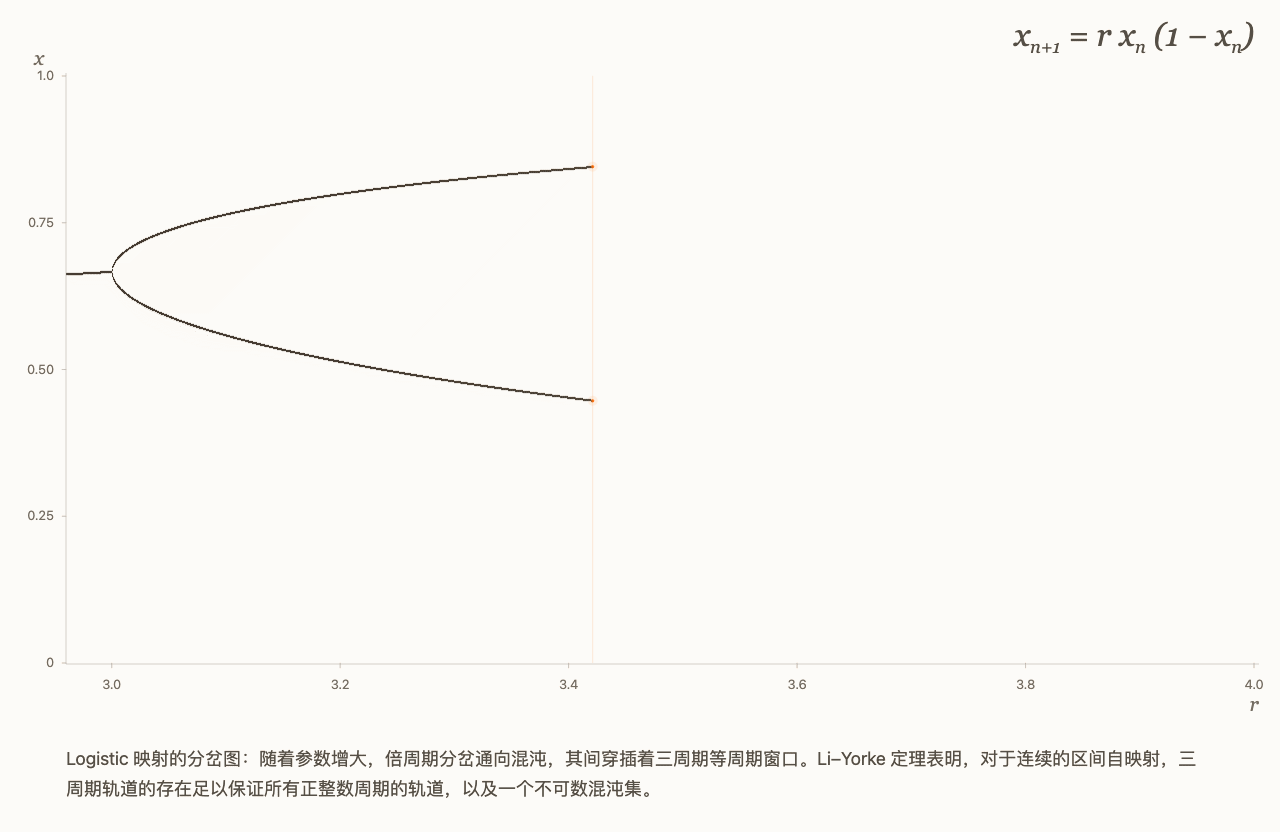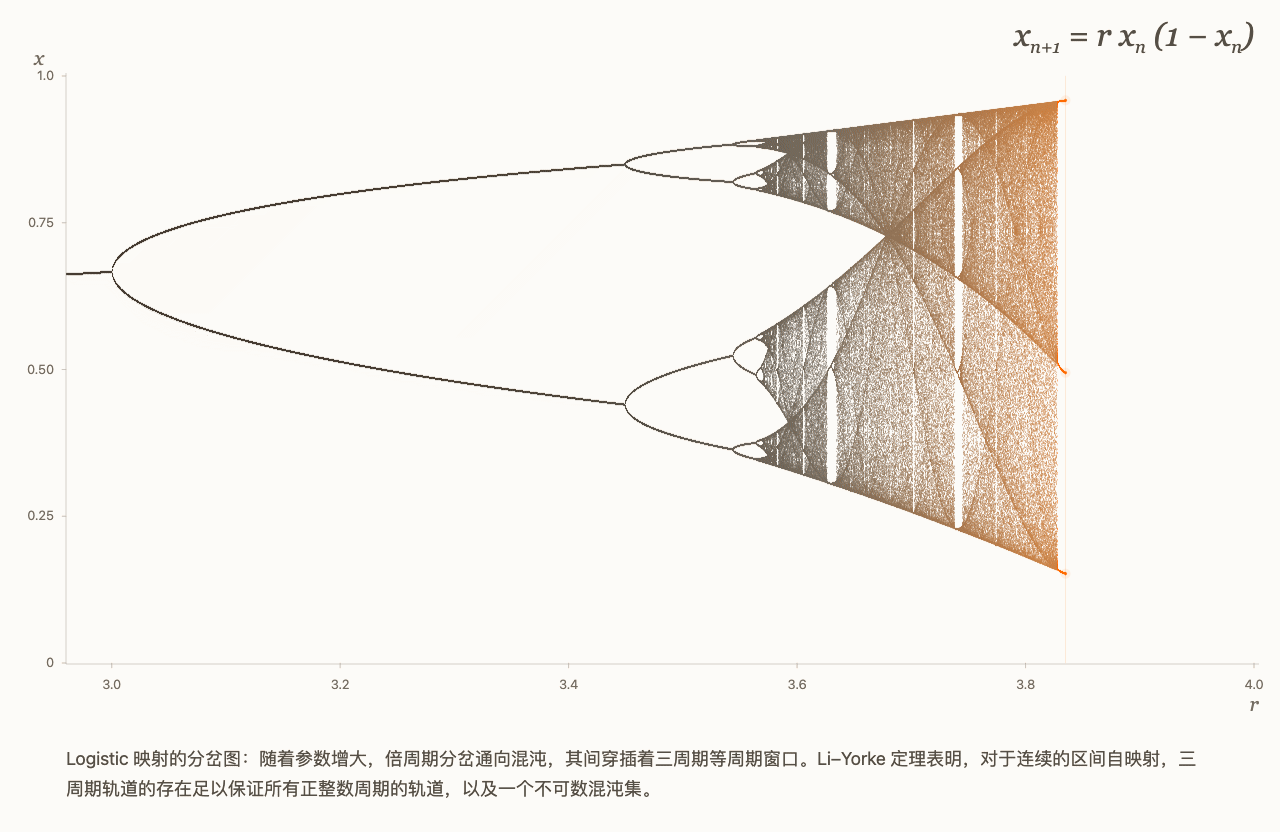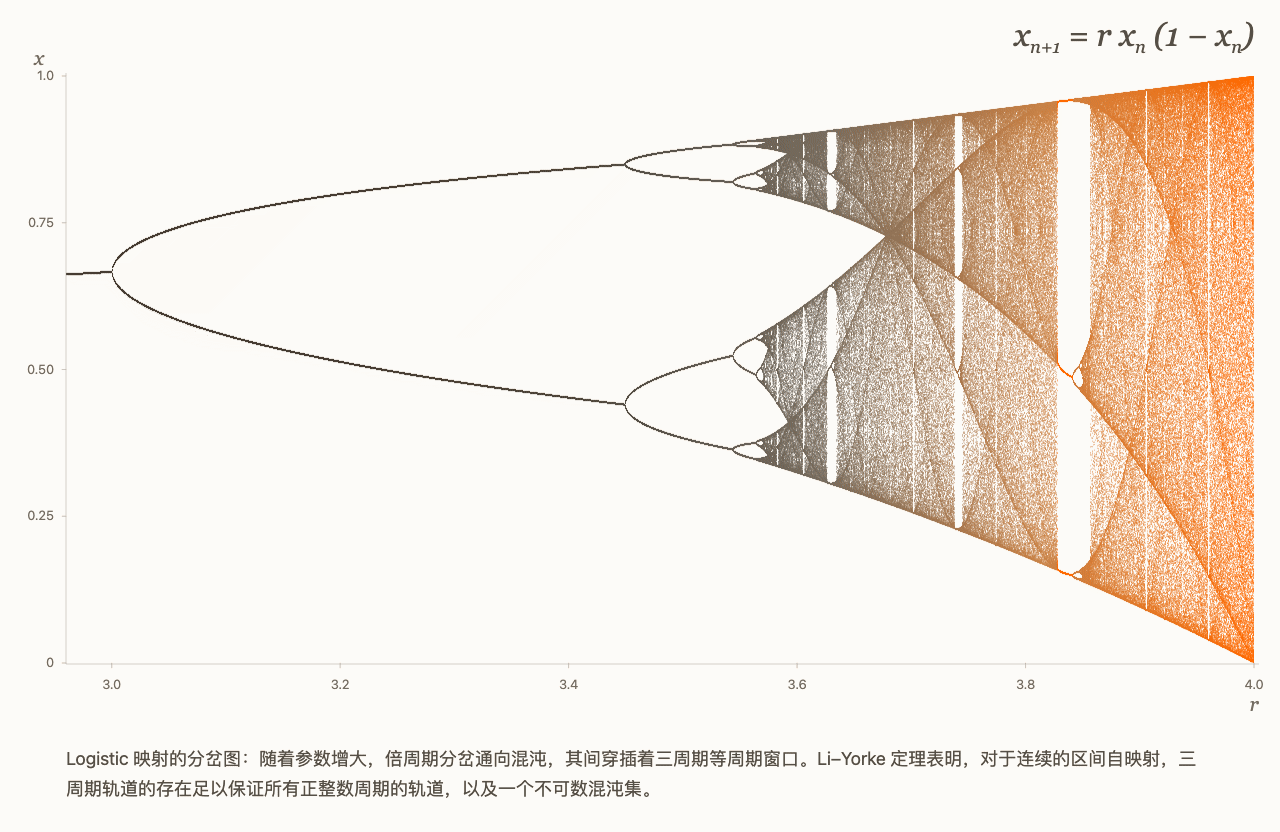
MiMo-V2.6-Pro 协助研究员,在 Lean 4 中完成了 Li–Yorke 经典论文《周期三蕴含混沌》原始主定理的完整形式化。该定理揭示:对于连续的区间自映射,一个三周期轨道的存在,就足以推出所有正整数周期的轨道,以及一个不可数的混沌集。
在研究员设计的探索策略引导下,MiMo-V2.6-Pro 通过 Sub-Agent 协作推进了定理叙述与证明的形式化。经后续修订与整合,项目最终形成了 6000 余行 Lean 源码,完整证明通过 Lean 内核核验,无未完成证明占位。模型未接受过针对 Lean 的专项后训练,这一案例展示了其参与复杂形式化证明任务的能力。
代码驱动的内容创作与审美表现
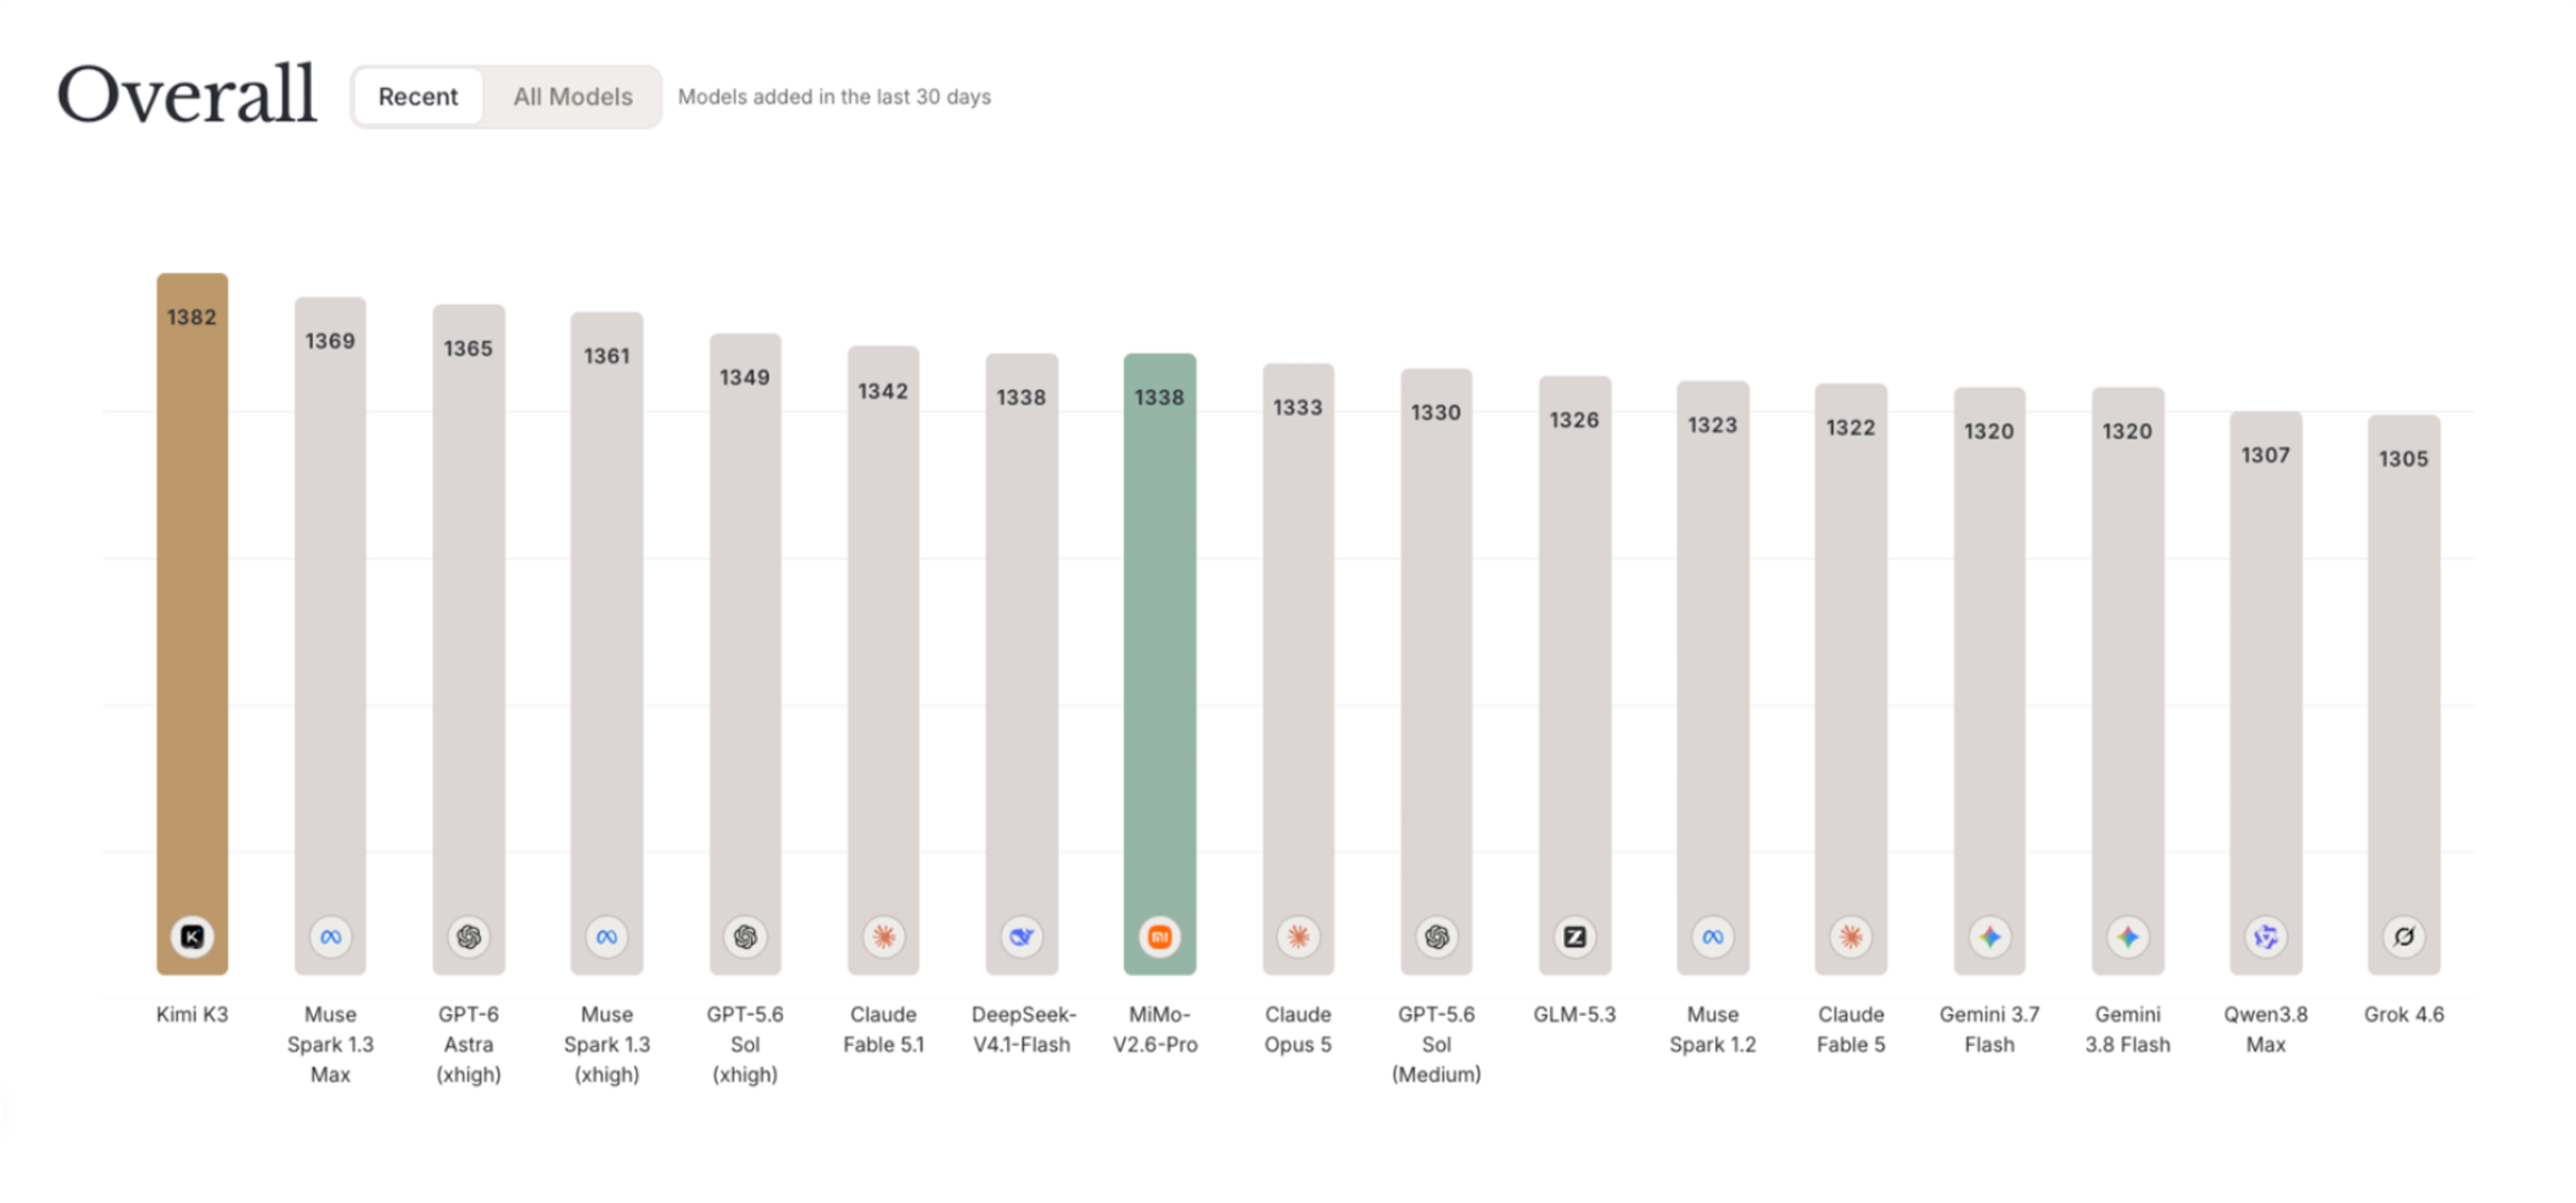
MiMo-V2.6 系列大幅提升了模型创建精美数字产品的能力,涵盖包括前端网页、Figma 设计稿、幻灯片、SVG、视频、音乐等在内的方方面面。在设计评测榜单 Design Arena 上,MiMo-V2.6-Pro 取得了与 Claude Opus 5、 GPT-5.6 Sol 相近的水平。
前端 & PPT 的审美表现
MiMo-V2.6 可以将简单的指令转化为完整的前端界面和 PPT,生成结构化的布局并精心设计美观的组件、交互元素和丰富的动画效果。还熟练运用 Figma 和图像/视频生成工具,制作符合整体风格的视觉素材,在字体、配色和图文编排上保持协调,兼顾审美表现与阅读、交互体验。
视频创作
MiMo-V2.6 能够端到端完成高质量视频创作。在创意与产品宣传视频中,MiMo-V2.6 可根据用户需求完成视觉设计、镜头与动效编排、配乐合成及节奏卡点;在科普视频中,它能将傅里叶分解(Fourier Decomposition)、凸包(Convex Hull)等抽象概念转化为通俗解说与连贯动画,并调用 MiMo-V2.5-TTS 合成旁白,与画面精准对齐,从而将复杂知识转化为观众可轻松理解的生动内容,实现从概念拆解到成片输出的全流程自动化。
音乐创作
在 MiMo-V2.6 中,我们进一步强化了模型的音乐理解、审美判断与知识运用能力,探索模型在音乐创作中的应用。它已展现出创作 Demo 级音乐作品的能力,以及辅助专业作曲与编曲人员开展创作的潜力。
在这一案例中,MiMo-V2.6-Pro 根据要求创作了一首包含约十种乐器的管弦乐作品,完成乐谱生成后,自主将其转换为 MIDI。作品体现了模型对不同乐器分工与配器关系的理解,也展示了它将音乐知识用于旋律创作和整体编排的能力。
开始使用
使用 Xiaomi MiMo Desktop 桌面客户端
随着新模型发布,MiMo Desktop 桌面客户端及会员订阅方案同步上线,欢迎通过下方链接下载体验。订阅会员即可使用 MiMo-V2.6-Pro 和 Flash 模型,也可配置自己的 API Key 使用客户端。
🔗: https://mimo.xiaomimimo.com/desktop/
MiMo Desktop 同步上线 MiMo-V2.6-Pro 的 UltraSpeed 超高速模式,提供最高 20 倍的推理速度,满足强实时交互与对响应速度敏感的场景。
原邀测活动将在 1 周后结束,已获得邀测资格的用户切换模型名称后方可继续使用。
接入 Xiaomi MiMo API
同时,MiMo-V2.6 系列已上线 Xiaomi MiMo 开放平台,API 价格维持不变。
MiMo-V2.6-Pro 同样于开放平台提供 UltraSpeed 超高速模式,提供最高 20 倍的推理速度。
模型定价如下:
全面开源
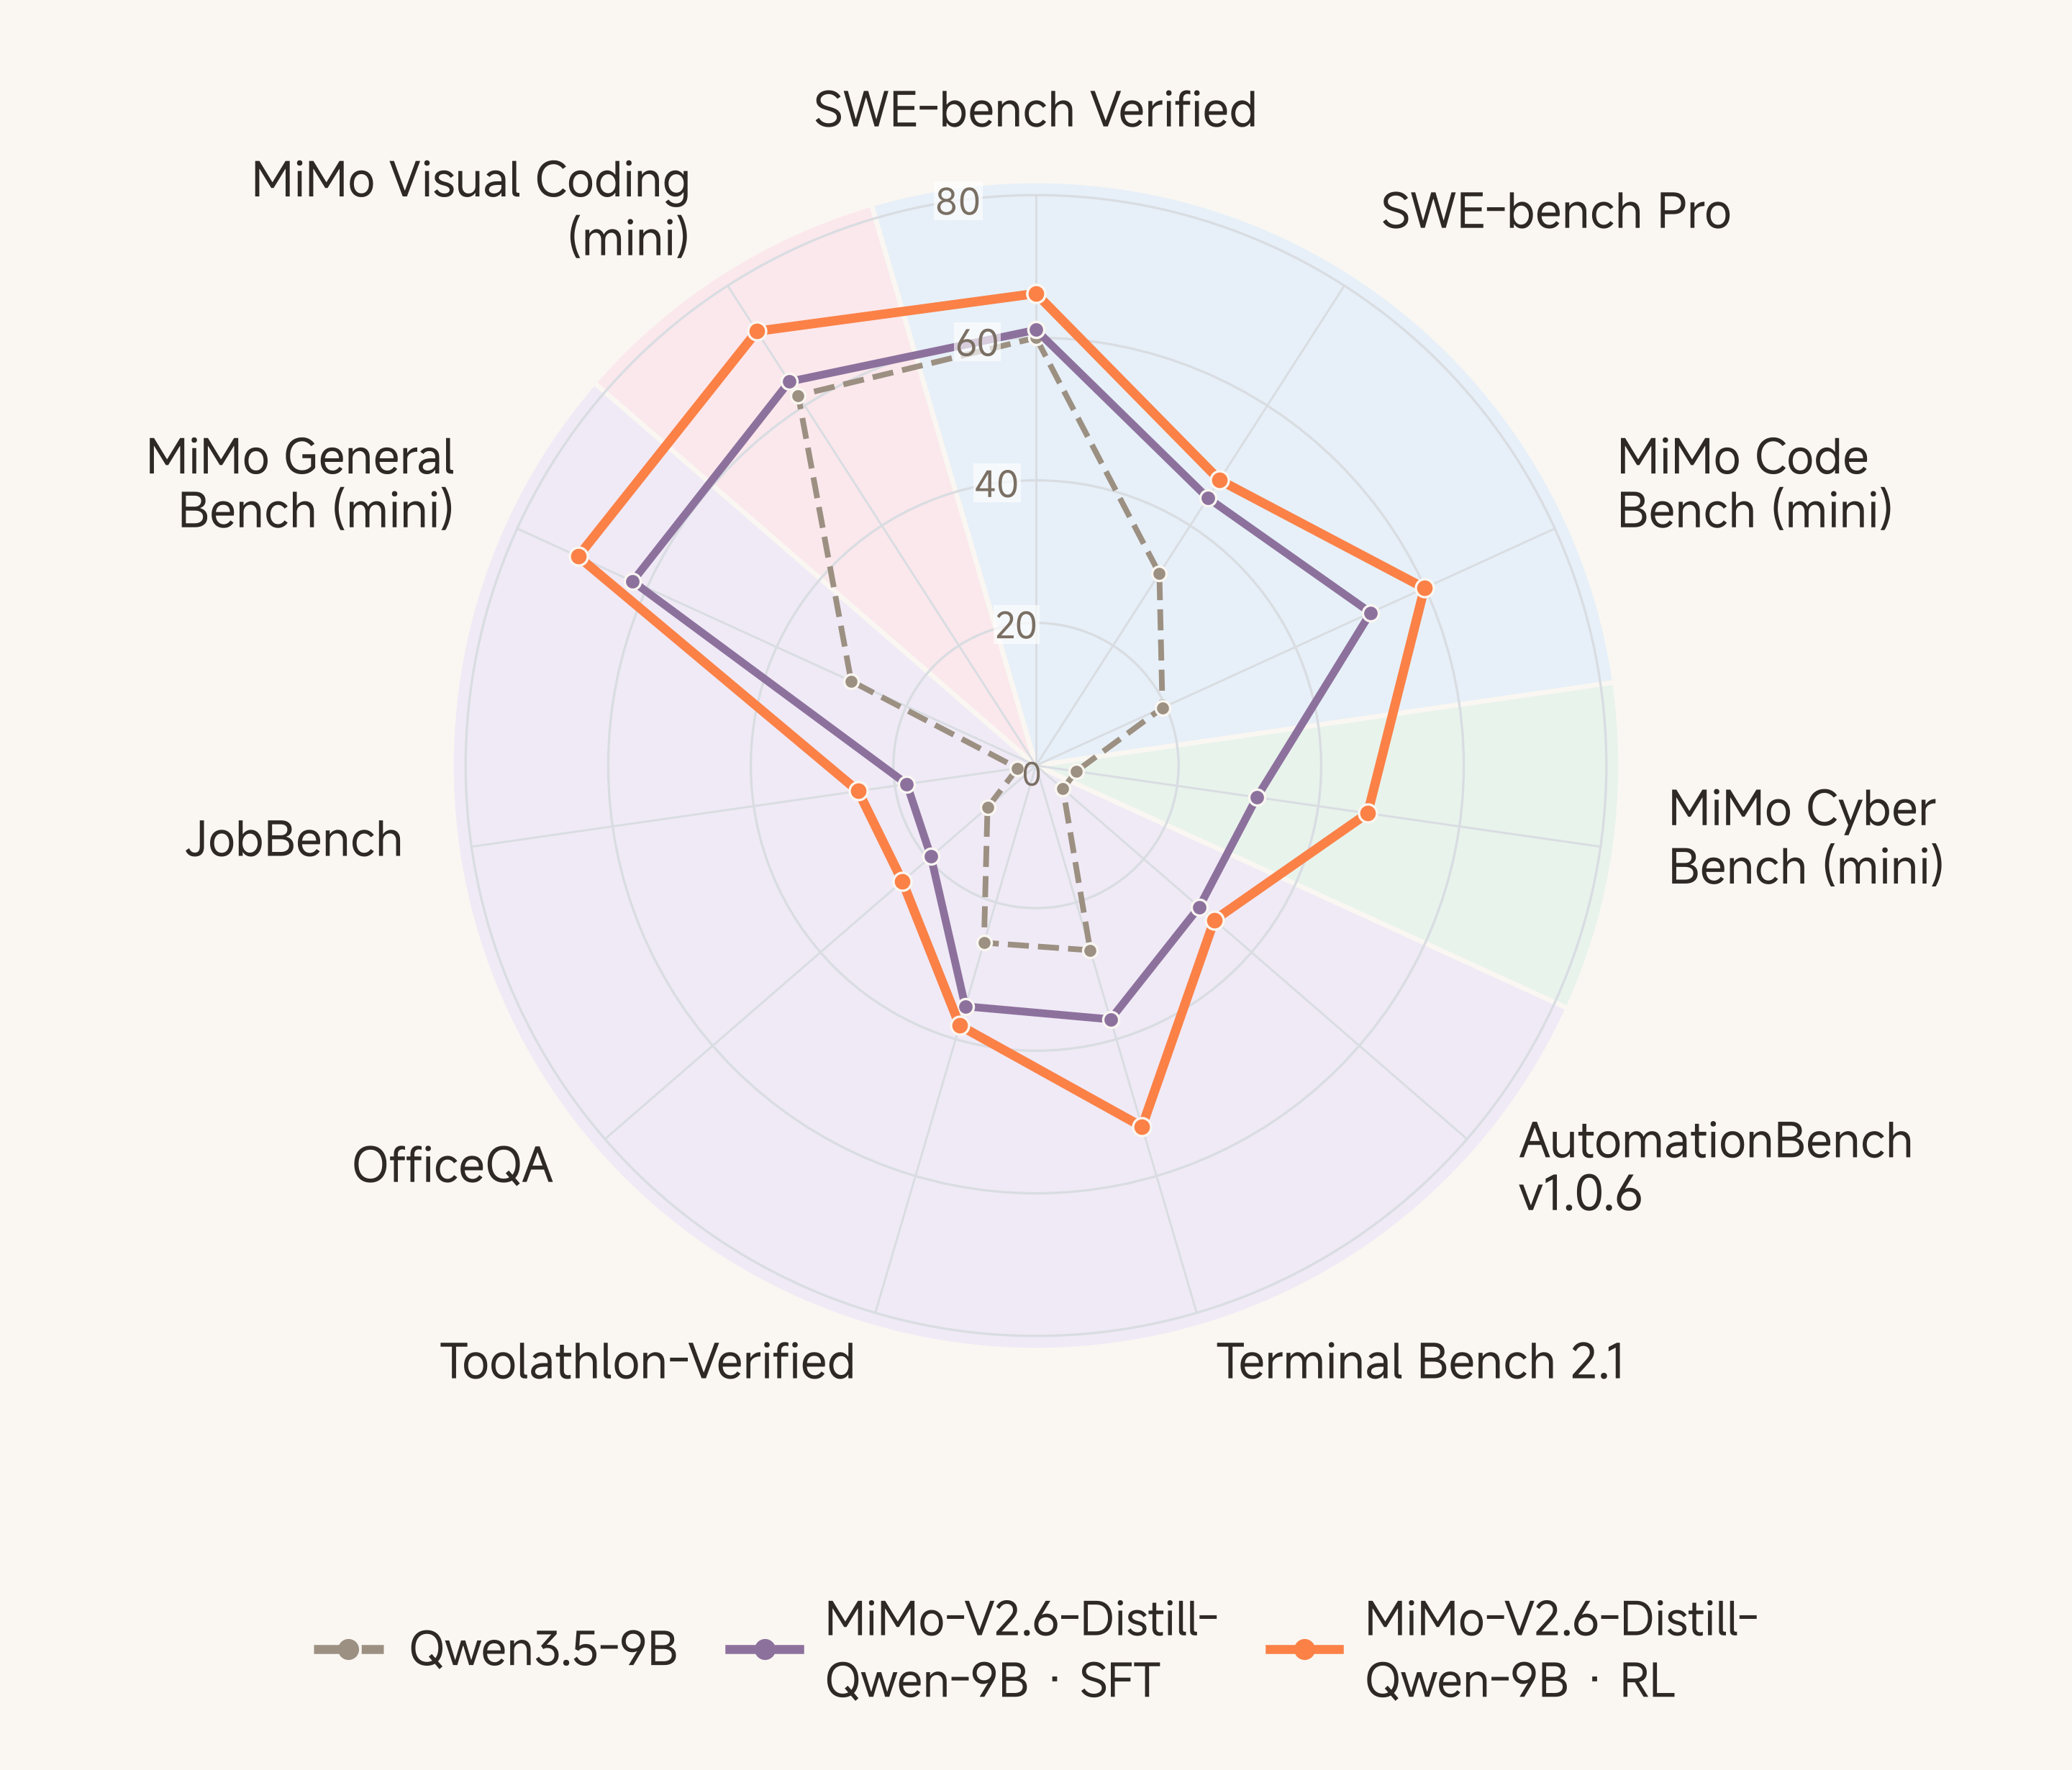
我们全面开源 MiMo-V2.6-Pro、Flash 模型权重与技术报告,同步开放 MiMo-V2.6-Distill-Qwen-9B 及配套 RL 研究资源,分享经过验证的训练实践,以下是详细开源内容:
-
7k+ 高质量 RL 任务环境: 覆盖软件工程、漏洞复现、知识型工作、网页设计开发四类智能体任务。以 MiMo-V2.6-Distill-Qwen-9B 为起点展开 RL 训练,在 11 项评测中均较 SFT 基线取得提升:SWE-bench Verified 从 61.1 提升至 66.2,MiMo Cyber Bench 从 31.3 提升至 47.0,Terminal Bench 2.1 从 37.1 提升至 52.8,MiMo Visual Coding 从 64.0 提升至 72.4;
-
端到端 RL 训练框架:基于 verl、uni-agent 和 mini-swe-agent,覆盖环境交互、轨迹采集、奖励评估与策略优化的完整训练流程。结合开放的模型与任务环境,支持社区围绕训练算法、奖励机制和 agent harness 开展研究与迭代;
-
轻量可组合的 Harness: 开源极简 mini-harnesses,将系统提示、工具与上下文管理解耦,构建多样且可控的训练配置。通过 Multi-Harness Training,能够将多样性和整洁性纳入 RL 训练,提升模型在不同框架、包括未见框架上的泛化能力,支持社区自由组合框架组件、拓展训练配置,持续探索新的研究方向。
希望这次分享能为社区持续探索强化学习算法与智能体机制提供共同基础,推动 Agentic RL 研究不断向前。
开源链接:https://huggingface.co/collections/XiaomiMiMo/mimo-v26
注意:调用 API 时请使用全小写模型名 mimo-v2.6-pro、mimo-v2.6-flash、mimo-v2.6-pro-ultraspeed。